21世纪经济报道记者邓浩
从基础模型训练到机器人进厂干活,真机数据正在成为具身智能落地的关键环节。
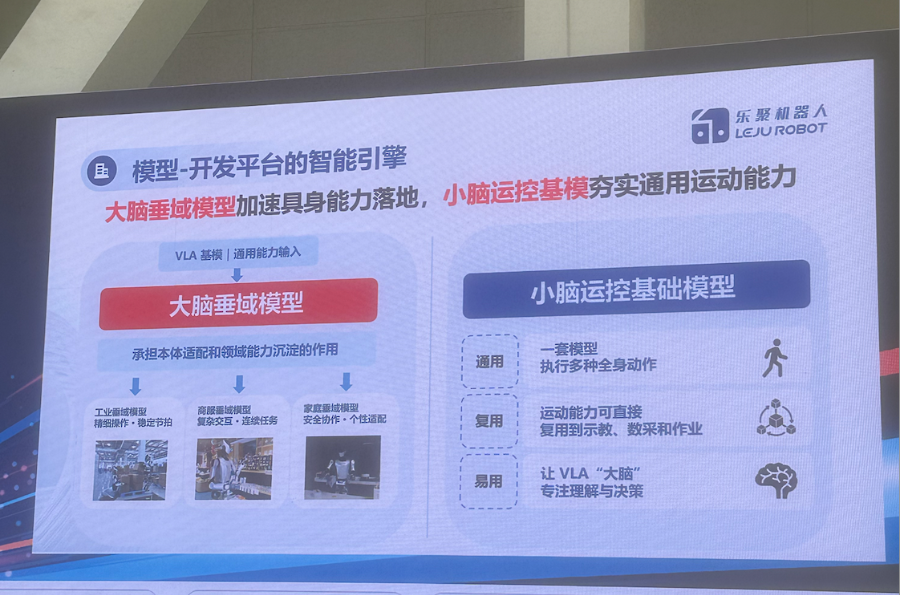
10月28日,在中国汽车工程学会举办的2026具身智能机器人大会暨具身智能主论坛上,乐聚CEO常琳表示:“具身智能模型落地不同阶段,需要不同类别的数据。真机数据是推动具身智能规模化应用落地的核心。”
(图片来源:记者摄于会议现场)
具体而言,在常琳介绍的训练路径中,预训练、中训练、后训练与真机强化承担着不同任务,对数据的需求各有侧重。预训练通过第一人称视角数据、手持夹爪采集及真机数据等多种来源,构建具备泛化能力的基础模型;进入具体行业后,还需进一步提高任务执行的准确率。
这也是乐聚强调“中训练”的原因。平台企业围绕三至五个场景,利用数千小时量级、以真机遥操作为主的数据训练垂域模型,再交由开发者面向具体任务开展后训练。常琳介绍,后训练通常使用约100至200小时的真机遥操作数据,随后进入真实场景采集在环数据,进行真机强化。
这一路径意味着,基础模型的通用能力,需要经过行业与任务数据的逐层适配,才能转化为生产现场的作业能力。真机数据的价值,也体现在让模型持续接触具体环境、操作对象和实际任务要求。
数据能否复用,则进一步影响部署规模。常琳指出,过去存在一台机器人采集的数据只能由自身使用、难以迁移至其他机器人的问题。“数据的复用非常重要,决定了它规模化的这种能力。”如果每次部署都要重新积累数据,训练与交付的投入就难以摊薄。提升数据和模型的复用程度,是扩大应用的重要前提。
在工业现场,乐聚已开始验证这条路径。据常琳介绍,在杭州兆丰机电的汽车机加工小件上料场景中,机器人已实现常态化运行,作业效率约为人工的60%至70%,工厂内约有15台机器人持续作业。这些进展使模型能力能够接受真实工况的检验,也为后续优化提供具体依据。
从数据走向应用,还需要降低开发门槛。常琳强调,客户需要的是“一套能开发、能验证、能部署、能持续改进的能力”。乐聚正通过动作编辑、技能开发、模型调用和部署工具,让开发者更便捷地把数据与模型转化为场景解决方案,并在实际业务中获得收益。
开放数据是扩大参与范围的另一环。据常琳介绍,乐聚以OpenLET开发者社区为牵引,贯通国产数据、模型与算力全链条,构建自主可控的具身智能产业生态。目前已累计开源10万分钟真机数据,相关开源数据集下载量超过600万次,数据类型涵盖第一人称视角数据、仿真和合成数据等。通过开放数据、模型与工具链,乐聚希望吸引更多团队参与开发,让一线需求更快反馈至平台。
在某种程度上,对具身智能来说,规模化的关键在于把真实数据转化为可重复交付的能力,并让更多开发者能够使用这些能力。常琳所强调的生态建设,正是要将数据积累、模型训练与场景应用连接起来,让机器人在更多具体岗位上创造价值。


