过去几个月,OpenAI、Anthropic、Google 都在往物理世界加码:招机器人人才、补真实世界数据、研发能控制机器人的模型。一个问题也随之被摆上台面:通用大模型,会不会成为机器人的“默认大脑”?
10月20日,具身评测平台 RoboColiseum(机器人角斗场)给出了第一组正面交火的实测成绩。Claude Opus 5.5、GPT-6 Astra、GPT-6.1 Sol、Gemini 4 Argon 四款旗舰模型同场竞技,像角斗士一样被放进同一套规则里比试:谁能听懂指令、看准位置、完成操作,并在环境变化后继续把任务做好。
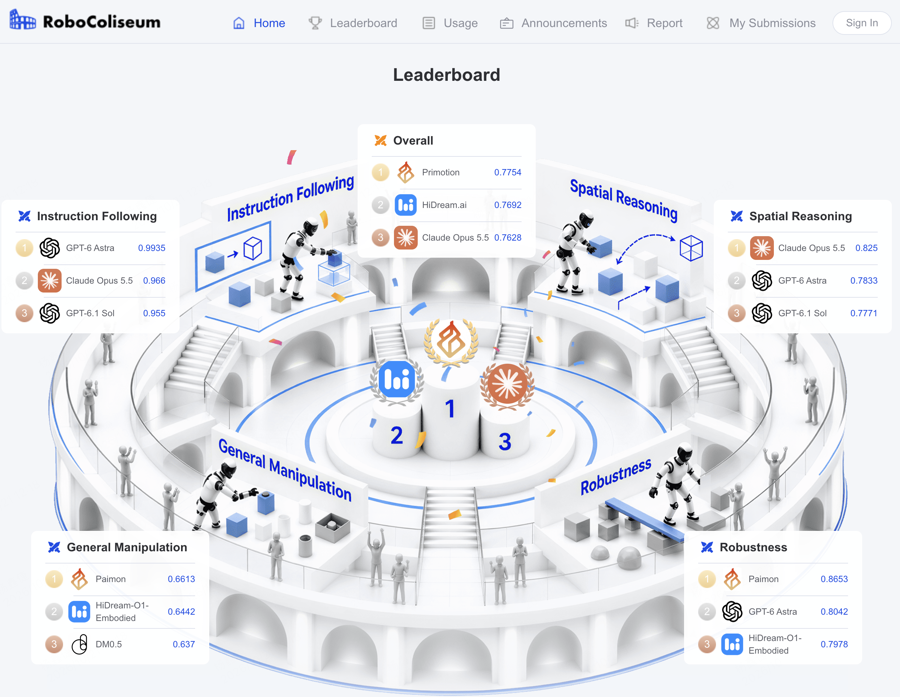
从四款旗舰模型的综合得分看,Claude Opus 5.5以76.28分排第一,GPT-6 Astra以75.99分紧随其后,GPT-6.1 Sol为70.91分,Gemini 4 Argon为66.86分。
Opus的优势不只在总分。它全轮评测的总消耗最少,也就是“干活更省”。在图像质量受扰动的测试里,Opus 得分 76.47,Astra 为 67.60,Argon 为 59.57,GPT-6.1 Sol 则跌到 18.36。Astra 也有自己的强项:指令跟随得分 99.35,整体扰动适应最强;Opus 则在空间理解、通用操作上领先。
更关键的是,四款模型共用完全相同的控制框架和原始任务指令。比的不是谁更会写提示词,而是模型本身在机器人场景里的“原生能力”。
理解层大模型碾压,操作层策略模型守擂
这场对决最有价值的发现,是能力边界第一次被量化清楚。
在“听懂指令”和“看懂空间”这两层,旗舰大模型形成明显优势。零样本入场、零任务微调,四款大模型就拿下66.86到76.28的综合评分。听懂指令、看懂位置,通用大模型确实已经很强。
但一到“动手”,局面就变了。抓取、开门、倾倒、分拣这些需要做准做稳的通用操作,四款大模型得分只有38.79-46.70;四款专门做机器人动作的策略模型则拿到63.20-66.13。总榜上,策略模型Paimon以 77.54 分、HiDream-O1-Embodied以76.92分占据前两名,压过Opus 5.5 的 76.28 分。
这意味着旗舰大模型“理解”过关,但“操作”这张卷子,它们还没及格。卷面最高分,仍写在策略模型名下。
Astra会全身协同,也会卡在灵巧手
围绕 GPT-6 Astra,研究团队做了七组“拆零件”实验,其中三组结果很能说明问题。
撤掉执行反馈后,平均规划决策次数从16.7次暴涨到35.6次。模型不知道“刚才那一下做到没有”,只能靠试错硬扛。删掉历史记忆后,积木入盒成功率从100%跌到50%:失败的情况都已经抓起积木,却在放置阶段反复重复动作。把末端目标改成直接输出关节增量后,Astra仍完成了10个任务中的8个,但需要更多执行步数。
在补充探索中,Astra的全身协同和跨本体操作很亮眼。丢垃圾时,它能指挥机器人移动底盘、降低躯干、伸臂抓起目标,再转向、调整位置,把垃圾送进桶里;开门后还能继续控制底盘穿过去。同一个棋子收纳任务,换到四种不同机器人身体上,它也能完成拾取与放置。
但灵巧手和精细操作仍是明显短板。叠碗实验中,Astra能根据视觉和机器人状态调整手指、手腕,却始终没能稳稳抓起一只碗;取书也多次调整姿态后失败。圆形积木入孔能成功,换成手机充电就不行:抓取成功,但充电口方向错误,最终无法接入。真机上,它能完成指定物体抓取、按颜色和大小抓积木、积木堆叠;增加深度信息后还能叠毛巾,但完整的叠衣服任务仍无法完成。
这意味着Astra已在全身协同、跨本体操作中表现突出,但灵巧手控制和精密插接,仍是需要突破的关口。对擅长这些能力的策略模型来说,机会就藏在这些具体任务里。
现在,GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon 已经踏入机器人角斗场。本轮评测暴露的短板——精细操作和灵巧手控制,正是后来者可以战胜它们的地方。
RoboColiseum平台由hugging face、英伟达、清华大学等高校、科研机构、开源社区、机器人企业和模型公司等联合共建。“斗兽场”正向研发视觉动作模型、世界模型和智能体系统的团队发出邀请:带着自己的模型进场,与三巨头旗舰正面交锋。


